日常生图可先试 Flare,严格的局部编辑可重点比较 Sunburst。两者的 API token 单价相同,单张费用却未必一致;本文结合官方说明与实测场景,讲清速度、细节保留和每张合格图片成本怎么比较,同时补充国内用户通过StartAI PS原生GPT生图功能直接选择两款模型的落地方法。
Flare 速度优先,Sunburst 精细编辑,两款能力均可在StartAI GPT生图面板中直接切换。文生图、图改图、透明背景一站搞定,不用单独对接OpenAI API,国内用户无需海外账号和信用卡就能直接体验。
立即使用StartAI:【点此一键下载StartAI插件】;
邀请码:【mKU7jz】,立领100积分,基础功能免费用!
一、先看交付要求,再选模型
如果你要为一篇文章生成配图、探索一组社交媒体视觉方向,通常会先判断主体、风格和构图是否合适。画面中的杯子换了一种把手形状,未必影响采用。此时可以从 Flare 开始,把迭代速度纳入选择。
如果输入的是客户已经确认的商品图,要求只换瓶盖颜色,那么瓶身比例、商标位置和标签文字就是不能随意变化的部分。画面再漂亮,只要商品结构被改了,也可能无法交付。这类任务更贴近 Sunburst 的官方定位,但最终仍要检查它在你的参考图上是否减少了这些错误。
| 你的实际任务 | 建议的起点 | 决定是否继续使用的检查项 |
| 从文字探索插画、封面或宣传创意 | 先用 Flare | 主体和风格是否符合需求,迭代等待是否可接受 |
| 日常配图批量生成,允许适度视觉变化 | 先用 Flare | 实际采用率、总用量和交付时间 |
| 改商品图的某一处,其他商品细节必须保留 | 重点比较 Sunburst | 指定部位是否改对,非目标区域是否出现意外变化 |
| 同一张品牌素材连续修改背景、道具和布局 | 两者用相同修改要求比较 | 每轮修改后,前面确认的内容是否仍保留 |
| 当前 Flare 结果已经符合交付要求 | 继续使用并记录表现 | Sunburst 是否带来足以抵消额外等待的收益 |
这里的建议是试用顺序,不是已测出的胜负。OpenAI 将 Flare 描述为面向日常高质量生图的快速模型;它同样支持图片编辑,因此简单改背景或更换整体风格不必一开始就排除 Flare。
二、“编辑更精确”应该检查什么
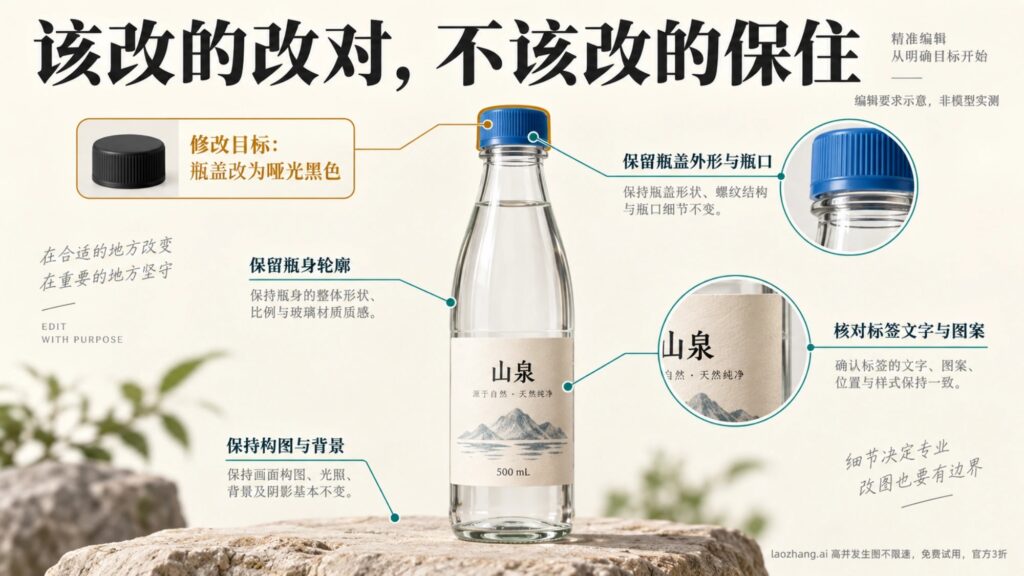
以一张饮料瓶商品图为例,制作方提出:“把蓝色瓶盖换成哑光黑色,其他部分保持原样。”评估时应拆成两个独立问题。
- 该改的有没有改对:颜色是否变成黑色,材质是否表现为哑光,修改是否覆盖完整瓶盖。
- 不该改的有没有保住:瓶盖螺纹和瓶口结构、瓶身轮廓、标签上的品牌名称、容量文字,以及原有构图是否仍然符合要求。只看整体观感,容易漏掉后一组问题。
可以把编辑要求写成这样:
仅把瓶盖的蓝色表面改为哑光黑色。保留瓶盖外形、螺纹和瓶口位置;保留瓶身轮廓、标签文字和图案、画面比例及背景。不要增加新的标识或装饰。这段文字用于让修改要求可检查,不保证模型一定遵守。检查结果时,把原图和完整输出并排查看;标签、接缝、透明边缘等关键位置需要放大。用于商品详情页的图片,应按实际发布尺寸再看一次,确认缩放后仍能读清必要信息。掩膜也不能替代这一步,如果“完全不变”指逐像素保留,把生成结果作为局部素材再用常规图片工具合成,通常更容易控制交付边界。
三、国内用户不用API,直接在PS里切换两款模型
对国内电商美工和设计团队来说,不用自己对接OpenAI API、处理海外账号和网络问题,通过StartAI PS插件的GPT生图功能就能直接选择GPT 2.5的Flare和Sunburst两款模型。
- 安装StartAI插件后,在PS中打开GPT生图面板,即可看到gpt2.5模型选择入口,支持一键切换Flare和Sunburst档位。
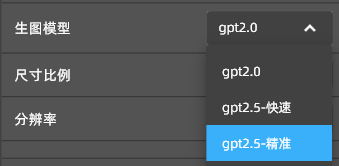
- 生成结果直接插入PS图层,不用网页端导出再导入,局部修改完成后直接在画布内核对商品细节、文字标签和透明边缘。
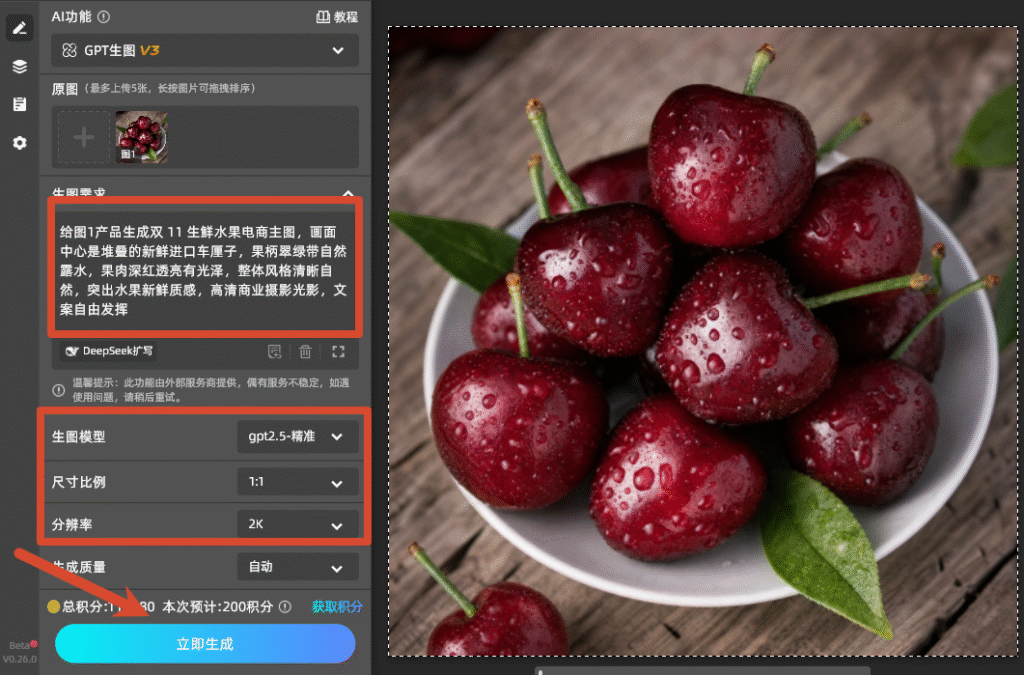
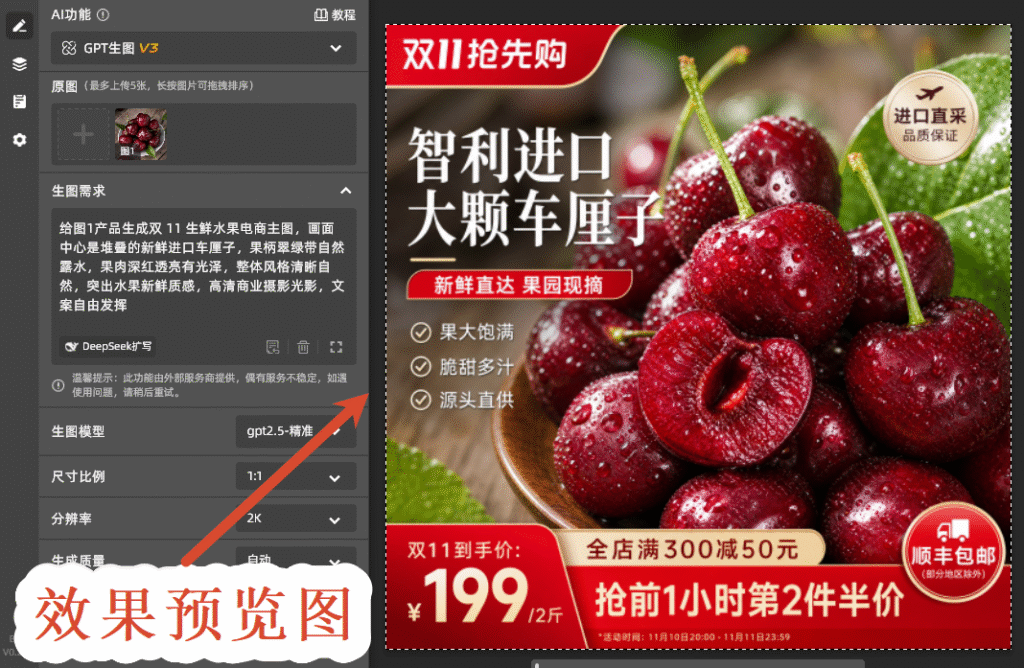
- 统一积分池按生成次数扣费,不用单独处理海外信用卡和美元账单,支付宝直接充值即可开始测试两款模型的实际表现。
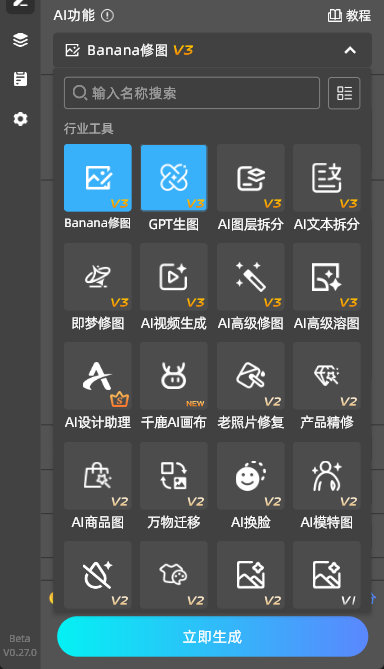
- 生成的图片不满意,直接用Banana修图功能框选区域重绘,不用离开PS环境就能完成从生图到精修的全流程。
四、model 与 quality 要分开决定
两款模型都支持 low、medium、high、xhigh、max 和 auto,默认是 auto。model 决定使用哪款模型,quality 决定本次生成的质量档位。把 Flare 从 high 改成 max,调用的仍然是 Flare;它不会因此切换到 Sunburst。
第一次做模型对比时,建议把尺寸与质量写明确,例如两者均使用 1536×1024、high,并提交同一份提示词和参考图。这样可以减少设置差异对判断的干扰。相同参数也不保证画质、耗时或用量一致,它只是一个容易复核的比较起点。确认哪款模型更适合任务后,再调整质量档位。草图和方向探索可以从官方建议的 low 开始;准备交付的素材则比较更高档位是否改善了实际缺陷。如果问题是主体理解错误或不该改的标签被改写,不能仅凭提高档位就认定问题已解决。
分辨率也不是两者的主要区别。二者都支持相同约束下的自定义尺寸;没有必要把“需要横图”当作改用 Sunburst 的理由。对比时优先使用业务真实需要的尺寸,而不是为了展示模型能力一律开到最大。
五、API 接入时,具体改哪个 model
通过 Images API 调用时,在生成或编辑请求的 model 字段直接指定以下一个值:
- Flare:gpt-image-2.5-flare,当前带日期的快照为 gpt-image-2.5-flare-2026-09-08
- Sunburst:gpt-image-2.5-sunburst,当前带日期的快照为 gpt-image-2.5-sunburst-2026-09-08
两款模型的当前快照和接口支持可在官方模型页核对。“GPT Image 2.5”是系列名称,接入时要使用具体 ID。做可复核的对比时,记录实际使用的模型 ID;若需要固定本轮版本,可使用对应的日期快照。如果你使用 Responses API,顶层 model 选择的是支持图片工具的主模型;Sunburst 或 Flare 要放在 image_generation 工具的 model 字段中。
接入后要确认拿到了可以打开的图片文件,而不仅是请求成功。Images API 的常见返回字段是 data[0].b64_json,需要解码并保存。账户是否有模型权限、是否需要组织验证和当前速率限制,应在自己的 API 项目中确认;ChatGPT 中能生成图片不等于该项目已经能调用这两个 ID。
六、Flare 能快多少:区分官方定位与实际耗时
“Flare 延迟降低 50%”不是说它比 Sunburst 快 50%。 官方发布的 API 比较基准是上一代 GPT Image 2。它不能换算成任意提示词下固定多少秒,也不能作为两款 2.5 模型之间的延迟差。
目前也有少量公开的配对运行记录。三组编辑测试统一使用 high 档、相同参考图和提示词、WebP 输出,报告的 Flare / Sunburst 页面耗时分别为 20.5 / 30.7 秒、22.7 / 38.8 秒和 19.7 / 29.4 秒。三组中 Flare 都更快,但每个任务、每款模型只运行一次,记录的是平台显示的耗时,不能据此推算稳定速度差、成功率或画质胜负。
你的使用者等待多久,还包含上传参考图、请求处理、下载图片和重试。评估交互体验时,应从开始提交到完整图片可用计时,重复运行后比较耗时中位数,并留意较慢请求。若产品会展示流式预览,可以另外记录首张预览出现的时间;预览更早出现并不代表最终图片更早完成。
速度也要和返工一起看。先得到一张图与先得到一张可以交付的图,是两项不同的记录。如果 Sunburst 的某次输出确实减少了后续修改,较长的单次等待可能换来更短的总交付时间;是否如此,需要在你的任务中验证。
七、API 单价相同,为什么实际成本仍会不同
截至 2026 年 9 月 19 日,两款模型的 OpenAI 直连 Standard token 费率完全相同。计费项中,文本输入未缓存 $5.00/百万token、命中缓存 $1.25/百万token;图片输入未缓存 $8.00/百万token、命中缓存 $2.00/百万token;图片输出统一 $30.00/百万token。
相同单价不等于每张图费用相同,更不等于每张合格图片成本相同。官方指南明确说明,即使质量档位相同,两款模型也可能消耗不同数量的 token;参考图等输入和后续返工也会产生费用。因此,既不能只凭 Sunburst 的定位认定它每张更贵,也不能只凭费率相同认定它与 Flare 每张同价。
估算时选对模型,再用 usage 核对。当前图片生成指南已提供 GPT Image 2.5 的输出估算计算器,设置为 1024×1024、high 后,页面估算为 1,756 个输出 token、每张 $0.05268。这个数值只估算图片输出,不包含文本和图片输入、流式预览,也不是分别调用两款模型测出的费用。auto 会随生成图片而变化,不适合用来锁定预算。
实际使用时,应确认计算器选择的是 GPT Image 2.5 对应选项,不要把旧版 GPT Image 2 的结果套用过来。第三方平台按张报价要按该平台的规则单独比较,StartAI 插件统一积分池计费,不用单独对接OpenAI API,更适合国内中小团队直接测试两款模型的实际单图成本。
八、用自己的任务做最后决定
先从日常工作中选取有代表性的任务,而不是只用一条容易出好图的提示词。新图生成、商品局部修改和连续编辑应分开记录,因为同一款模型在不同任务里的价值可能不同。提交前写清采用标准;例如商品编辑必须同时满足“瓶盖颜色正确”和“品牌标签无变化”,不能事后为了保留某张好看的图而放宽要求。
比较时保存相同的输入、显式尺寸与质量、模型 ID、完整输出、端到端耗时和响应 usage。对图片按预先写下的要求判断是否采用,并简短记录不采用的原因。若做重试,也保留这些请求和实际费用,避免只统计成功结果。
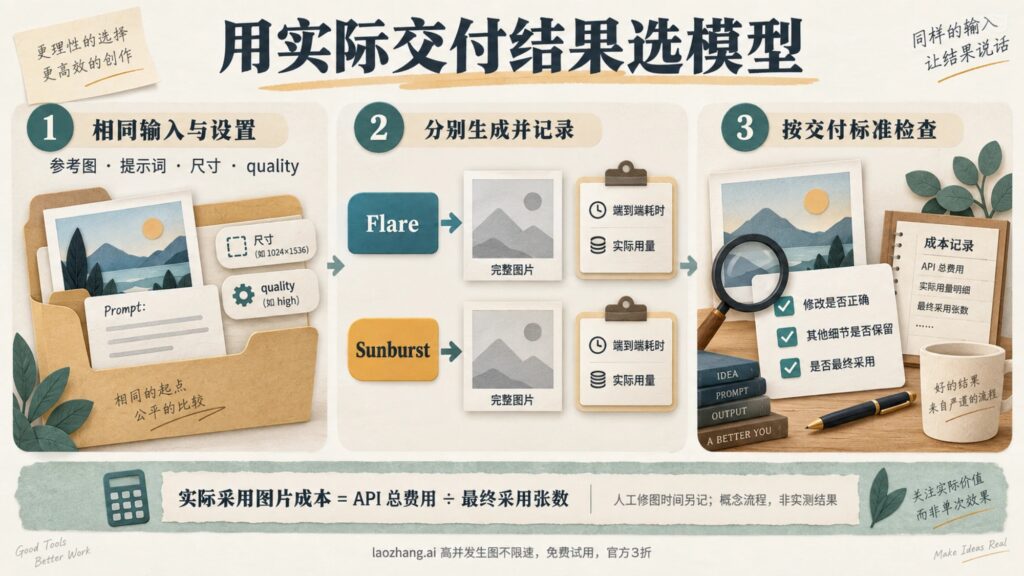
每张合格图片的 API 成本 = 本组任务实际产生的 API 总费用 ÷ 通过验收的图片张数
例如,假设一组任务总共花费 6 美元,得到 30 张合格图片,平均成本就是每张 0.20 美元;另一组花费 7.20 美元,得到 40 张合格图片,平均为每张 0.18 美元。后一组总花费更高,但每张合格图片更便宜。这只是说明计算方法的假设,不代表任一模型的价格或合格率。
最后按任务分配模型:Flare 能稳定满足要求,就继续用于这类日常任务;Sunburst 若在关键编辑中减少意外改动、反复生成或人工修补,再把这些任务交给它。如果两者都无法保住必须准确的商品信息,就调整编辑和合成流程。对团队最有用的结论,是哪一种任务应该调用哪一个模型,以及交付前还必须检查什么。
立即使用StartAI:【点此一键下载StartAI插件】;
邀请码:【mKU7jz】,立领100积分,基础功能免费用!