
GPT Image 2.6(含 ChatGPT Images 2.6、GPT-Image-2.6)支持原生直出 GIF 与 SVG 导出。国内接入并投入生产环境,主流路径是通过已托管官方底层接口的国内 API 聚合平台,无需自行处理海外直连。本文从实际压测经验出发,讲清入口选择、参数配置、缩水接口辨别,以及配套的 StartAI 后期处理流程。
一、GPT Image 2.6 更新了什么,为什么值得接入 API
过去 AI 生图解决了画质和文字排版,交付物仍是静态图。要让画面动起来,通常要在生图接口后再串图生视频模型,或在服务端拆帧调用 ffmpeg 合成 GIF,链路较长,还容易出现帧间角色走样、画风跳变。
ChatGPT Images 2.6 把动图和矢量图纳入原生 API 能力。
- 原生直出 GIF:请求中直接指定输出格式为 gif,支持自定义 2 至 64 帧及单帧时长,服务端返回可循环播放的动图,无需后端拼帧。
- Flare 与 Sunburst 双模型分工:Flare 速度优先,适合草稿探索和低时延交互;Sunburst 质量与一致性优先,主打多轮局部精修、跨帧角色稳定,原生支持 SVG 矢量导出,缩放不失真。
- 精灵图与参考图生图:支持上传参考图锁定角色构图,直接生成多姿态精灵图并转为连贯动画,适合游戏原型、电商微动效主图。
二、国内四种调用入口对比
实际可用的入口大致四类。
国内托管 API 聚合平台:接入官方通道,专线直连,一个 API Key 统一调度 Flare 与 Sunburst,参数透传完整,适合需要在生产环境稳定运行、做商业交付的团队。
国产大模型自带生图 API:国内网络顺畅,但底层并非 GPT-Image-2.6,不支持原生 2 至 64 帧 GIF 与 Sunburst SVG,只适合生成普通静态配图。
个人搭建的小中转站:单价看起来低,常见偷换底层路由、掺入降级模型,并发升高后易出现 502 超时,不适合正式项目。
自行绑定海外卡直连官方:跨国网络抖动明显、风控封号风险高,长时段 GIF 请求容易断连,仅适合具备海外主体和运维能力的团队。
对以技术交付和业务稳定性为核心的团队,第一类更可控,省去多套 SDK 适配和多资金池维护,也避免长连接被截断。
三、为什么有的接口调出来效果明显缩水
常见原因是路由层的模型降级和参数截断。
实测某家小中转时曾遇到:请求体写的是 GPT-Image-2.6-Sunburst,要求导出细节丰富的矢量风格和高帧率 GIF,返回图片文字边缘发毛、细节模糊,多轮编辑时角色脸部直接崩坏。排查日志后发现,网关层把请求转发到了旧版甚至开源量化模型,帧数控制参数被静默丢弃。
判断标准:调 2.6 时若发现响应异常快但画面粗糙、中文排版边缘发虚,或指定 24 至 32 帧 GIF 出来明显丢帧卡顿,先别改提示词和业务代码,多半是上游接口降配了。核验时应看参数是否完整透传,而不是只看返回状态码。
四、托管平台的实际调用方式
以国内托管 API 聚合平台的常规架构为例。
模型选择:需要在电商活动期生成带促销文案的动态主图时,路由到 Flare,设置 16 至 24 帧、单帧 80 毫秒,直出节奏明快的循环 GIF。
质量优先场景:前端 UI 团队需要空状态插画、加载动画或高清主视觉海报时,模型名改为 Sunburst,拉取 SVG 矢量源码或高分辨率精修图。
多模型统一管理:文案生成、视觉生成等不同模型在同一控制台、同一套令牌体系下管理,只需一个 Base URL 加一个密钥,减少多厂商 SDK 适配成本。
连接稳定性:多帧 GIF 单次计算量大于静态图,对 Keep-Alive 和网关吞吐要求更高,需确认平台是否具备多通道负载均衡和专线加速。
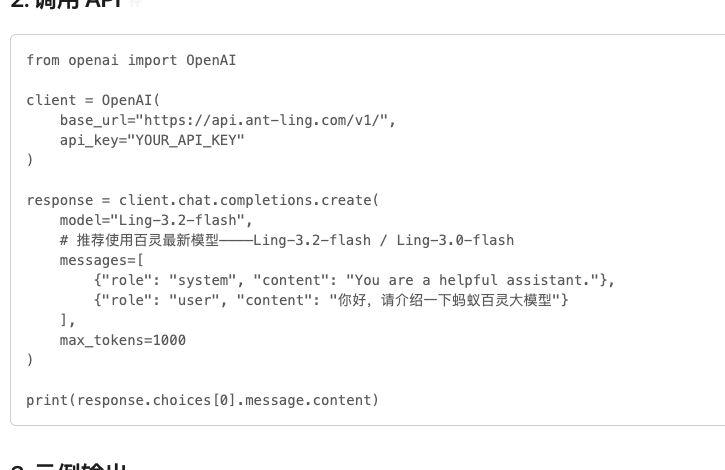
协议兼容方面,主流托管平台均兼容 OpenAI 原生协议,只需替换 base_url 与 api_key,无需重构代码,可直接在 NextChat、LobeChat、Dify、Coze 等工作流中调用。
五、四条核验指标
辨满血还是降智:用同一组复杂提示词测试,比如包含中文字体排版的海报或指定 32 帧旋转视角 GIF。Flare 应响应快且画面干净,Sunburst 放大后细节扎实并支持原生 SVG,文字发毛、帧数参数失效的直接排除。
看原生参数支持度:完整支持 gif 与 svg 输出指定、2 至 64 帧范围调节、单帧毫秒级时长控制、多轮对话式编辑,而不是只有一个简化版文生图端点。
看并发稳定性与容灾:连续发起成组动图请求,观察平均延迟和成功率,单次调通不能说明问题。
看计费透明度与分组管控:支持按实际调用量计费,可按项目组分配独立 Key 与额度上限,消耗明细可查,失败请求不产生额外消耗。
六、不适用的两种情况
- 零代码、只想用现成画布页面的个人用户:托管聚合平台交付的是标准 API 接口,需要配置 Key 并配合客户端工具使用,本身不提供在线修图画布。
- 要求物理隔离、权重必须跑在本地内网机房的机构:任何云端托管 API 都不适用,只能走开源模型私有化部署路线。
七、国内无门槛实操:StartAI GPT 生图教程
GPT Image 2.6 性能突出,但国内没有直连通道、API 调用门槛较高,普通用户难以直接上手。StartAI GPT 生图深度适配其核心能力,复刻 Flare 快速出图与 Sunburst 高精度精修的双模式优势,支持草图生图、参考图保真重绘、局部精准编辑、多轮稳定迭代,国内网络直接可用,无需密钥、无需部署,新手也能落地商用创作。
立即使用StartAI:【点此一键下载StartAI插件】;
邀请码:【EnwsYJ】,立领100积分,全部核心功能免费用!
核心适配能力
双模式适配:快速出图对标 Flare,精准对标 Sunburst,按需切换。
原生动图与矢量输出:适配 2 至 64 帧 GIF 生成与 SVG 矢量导出,动图可直接循环、矢量可无限缩放,无需再拼帧转码。
高保真参考生图:保留主体特征、光影质感,避免变形失真;精准局部编辑:指哪改哪,不破坏原图整体构图和细节。
多轮稳定迭代:反复修改画质不衰减,适配精细化商用打磨;草图转正:手绘草图一键生成高清成品,降低创作门槛。
零基础实操步骤
启动功能模块:打开 StartAI 或 PS 插件端,登录账号后找到 GPT 生图模块,进入创作界面。
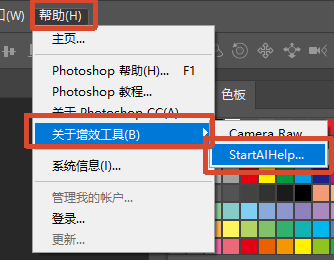
选择创作模式:草稿、日常配图选快速模式,对标 Flare;商用海报、精修产品图、科普图示选精准模式,对标 Sunburst。
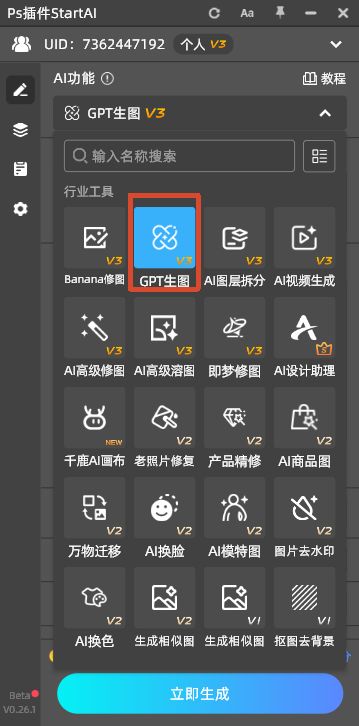
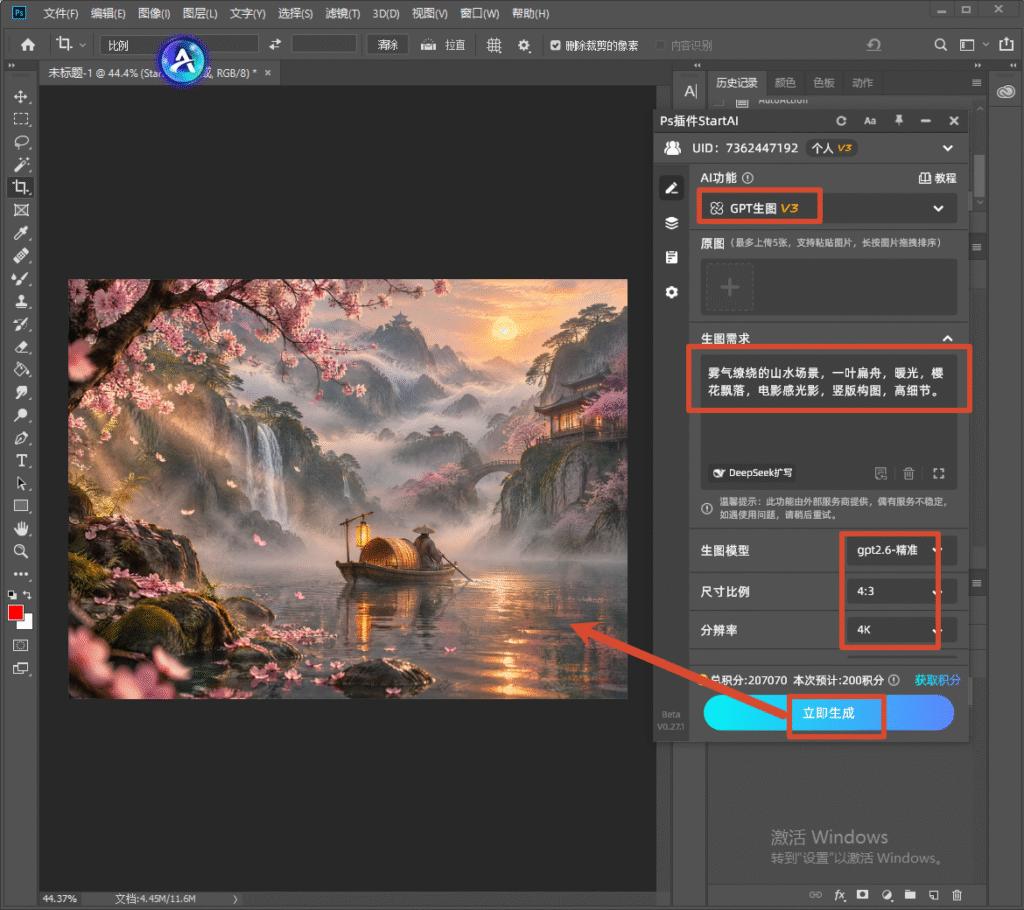
输入需求或上传素材:支持纯文字提示词、参考图上传、手绘草图导入,可复用英文提示词,也可用中文精准描述,系统自动适配最优参数。
设置画质与比例并生成:按需选择画质档位、画面比例,开启高保真还原与细节优化,点击生成获取高清成品,支持二次微调与多轮迭代。
八、常见问题
Q1:Image 2.6、ChatGPT Images 2.6 和 GPT-Image-2.6 是一回事吗?是同一代视觉模型体系,API 侧主要体现为 Flare(速度与动图导向)和 Sunburst(质量、编辑一致性与 SVG 导向)两个调用模型。
Q2:接入托管平台需要改现有 OpenAI SDK 代码吗?不需要重构,平台兼容 OpenAI 协议,替换 base_url 与 api_key 即可直接传模型名和 GIF/SVG 参数。
Q3:GIF 帧数与单帧时长怎么配更合理?表情包或按钮微动效 8 至 16 帧、单帧 80 至 120 毫秒,体积小节奏明快;商品旋转展示建议 24 至 32 帧、单帧 60 至 80 毫秒;叙事型动画可用到 64 帧。帧数越高资源消耗越大,先用少帧跑通最小闭环再放量。
Q4:多个项目共用大模型,如何避免账号与账单混乱?在密钥管理中为不同业务线创建独立令牌,分别设置通道分组、额度上限与有效期,主账户统一管理,成本与权限分开核算。
九、写在最后
GPT-Image-2.6 把动图与矢量图写进原生接口,2 至 64 帧、单帧毫秒级时长、Sunburst 的 SVG 导出,都是过去要靠拼接链路才能凑出来的能力,现在一次请求就能拿到。国内接入的关键不在能不能调通,而在调出来是不是满血:模型名对、帧数参数生效、多轮编辑不崩脸、并发时不超时,四项对上才算可用。
选入口时按业务性质反推,生产环境优先看通道完整度与容错能力,纯静态配图需求用国产模型接口即可,小中转与个人直连只适合验证概念。素材拿到后接上 StartAI 做后期校准,整条从生成到交付的链路才算闭环。
邀请码:【EnwsYJ】,立领100积分,全部核心功能免费用!
更多教程:2- 长按复制此条消息,打开抖音搜索,查看TA的更多作品。 https://v.douyin.com/h5twhH8ap18/ 2@3.com :4pm







